Faber Company 開発ブログ

ファベルカンパニーと読みます。

【参加報告】2026年度 人工知能学会全国大会(JSAI2026)に参加しました!

AIイニシアティブチームの稲岡です。

2026年6月8日〜12日にGメッセ群馬(群馬県高崎市)で開催された2026年度 人工知能学会全国大会(JSAI2026)に、Faber Company はシルバースポンサーとして協賛しました。 私を含む2人のメンバーが現地に足を運び、最新のAI研究に触れてきました。

今回は人工知能学会の創立40周年にあたる記念大会で、会期中には記念式典も執り行われました。規模も過去最大となり、参加者数は5,000名超、発表件数は1,397件にのぼったとのことです。

conf.ai-gakkai.or.jp

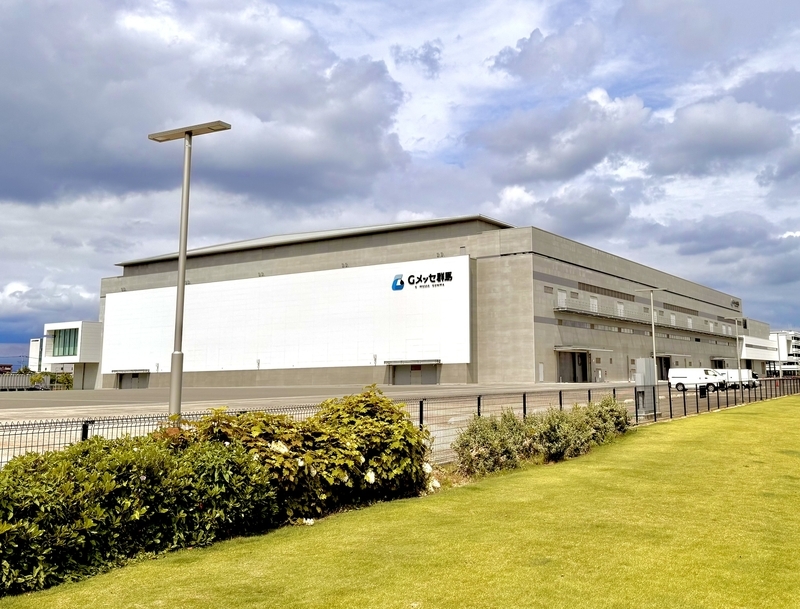
会場となったGメッセ群馬の外観
会場となったGメッセ群馬

参加の背景

ファベルは「辺境の知から、“マーケティングゼロ”を実現する」をパーパスに掲げ、Webマーケティングの支援やSEOプラットフォーム「ミエルカ」シリーズの開発を行っています。 近年はプロダクトの機能開発において生成AIや大規模言語モデル (LLM) を積極的に取り入れており、その能力をいかに引き出し、ユーザーへの価値提供につなげるかが日々のテーマになっています。

私はAIイニシアティブチームで研究開発に携わる立場から、最新の研究動向をキャッチアップし、プロダクト開発やマーケティング支援に還元することを目的に今大会へ参加しました。本記事では、数ある発表の中から私が特に関心を持った3件を紹介します。

注目した研究

LLMによるWeb記事ライティングにおけるアラインメント手法の比較

著者: 山本 彩弥加(横浜市立大学), 木村 賢(株式会社サイバーエージェント), 越仲 孝文(横浜市立大学)

https://pub.confit.atlas.jp/ja/event/jsai2026/presentation/4K1-GS-6a-06pub.confit.atlas.jp

コンテンツマーケティングでは、検索ユーザーに好まれる記事の制作が重要になります。 この研究は、そうしたユーザーの選好をLLMに反映させる手法として Direct Preference Optimization(DPO)と Kahneman-Tversky Optimization(KTO)を取り上げ、Web記事ライティングというタスクにおいてどちらがより有効かを比較したものです。

人手評価と LLM-as-a-Judge では可読性・記事内容のどちらの観点でも KTO モデルが DPO モデルを上回り、自動評価(MSTTR、BERTScore)でも同等以上の結果となりました。 長文かつ自由度の高いWeb記事ライティングでは、選好ペアを必要とするDPOよりも、絶対評価を用いるKTOのような手法が適している可能性が示されています。

ユーザーに好まれるWebコンテンツをどう効率的に制作するかは、まさに私たちが日々向き合っている領域であり、その基盤となる技術を研究の視点から捉え直す良い機会となりました。

他者の思考様式を学習したAIとの協働が創造的タスクの成果に与える影響

著者: 日野 恭佑(株式会社電通), 佐々木 一(東京大学 / 株式会社電通デジタル)

https://pub.confit.atlas.jp/ja/event/jsai2026/presentation/1G4-OS-13b-03pub.confit.atlas.jp

LLMがユーザーに過度に同調する「迎合(sycophancy)」や個人への行き過ぎたパーソナライズはLLMの思考を硬直化させるおそれがあるといわれています。 この研究は、自分ではなく他者の思考様式を学習したAIと協働する方が創造性を高めるのではないか、という仮説を広告コピー作成の実験によって検証しています。

実験の結果、他者向けにパーソナライズされたAIは発想の広がりや発見感、独創性を高める一方で、自分向けにパーソナライズされたAIは作業のしやすさや成果物への納得感、信頼感の面で優位でした。 さらに、利用者とAIの思考様式の差と独創性の関係は逆U字型であり、差が大きすぎても小さすぎても十分な効果は得られず、適度に他者性を持つAIとの協働が創造性を高めることが示されました。

この研究は、LLMを用いた創造的タスクにおいて、ユーザーの思考様式をそのままAIに学習させることが必ずしも最適とは限らないことを示しています。 どのような思考様式を学ばせるべきかは、今後のプロダクト開発でも重要な論点になりそうです。

大規模言語モデルの持つ価値観の定量化

著者: 安達 瑠斗(東京科学大学), 星野 智紀, 石塚 湖太, 川上 孝介(博報堂テクノロジーズ), 市瀬 龍太郎(東京科学大学)

https://pub.confit.atlas.jp/ja/event/jsai2026/presentation/1G4-OS-13b-02pub.confit.atlas.jp

この研究は、LLMにペルソナ(性別・年代・職業など)を与えて日常的な意思決定に関する多肢選択の質問に答えさせ、その回答分布が実際の日本人集団にどの程度近いかを定量的に検証したものです。 比較対象には博報堂生活総合研究所の「生活定点調査」の個票データが用いられ、回答分布の近さは1次のワッサースタイン距離*1に基づく指標で評価されています。

多くのモデルが「現実の人間集団同士でもっとも似ていない組み合わせ」の類似度にすら届かず、1つのモデルを除いてはランダムな回答分布のベースラインさえ下回りました。 つまり現状のLLMは日本人集団の価値観を十分には反映できておらず、アンケート調査の代替やマーケティングにおけるペルソナ分析といった用途には、まだ課題があることが示されています。

これは、以前の計算社会科学会大会(CSSJ2026)の参加報告で紹介した「シリコンサンプリングは大規模社会調査と互換性を有するか?」という研究と、同じ問題意識を共有していると感じました。 どちらの研究も、LLMにペルソナを与えて人間の代わりにアンケートへ回答させ、その回答が現実の人間集団の分布をどこまで再現できるかを定量的に検証しており、いずれも現状のLLMでは十分に再現しきれないという結論に至っています。

fabercompany-dev.hatenablog.com

人間が生み出したWebコンテンツなどを大量に学習しているLLMであっても、現実の人々の価値観をそのまま映し出しているとは限りません。 Webマーケティングのように人間の価値観が結果を左右するタスクにLLMを用いる際には、対象とする人々の価値観をどのように反映させるかが重要になると考えさせられました。 LLMを人間の代替として用いることの難しさと、その妥当性を検証する大切さを改めて実感する研究でした。

まとめ

人の選好・創造性・価値観をLLMがどこまで扱えるのかという問いは、LLMの能力を引き出してプロダクトの価値につなげていくうえで避けて通れないものだと感じます。 今大会で得た学びを社内に持ち帰り、我々の今後の取り組みに活かしていきたいと考えています。

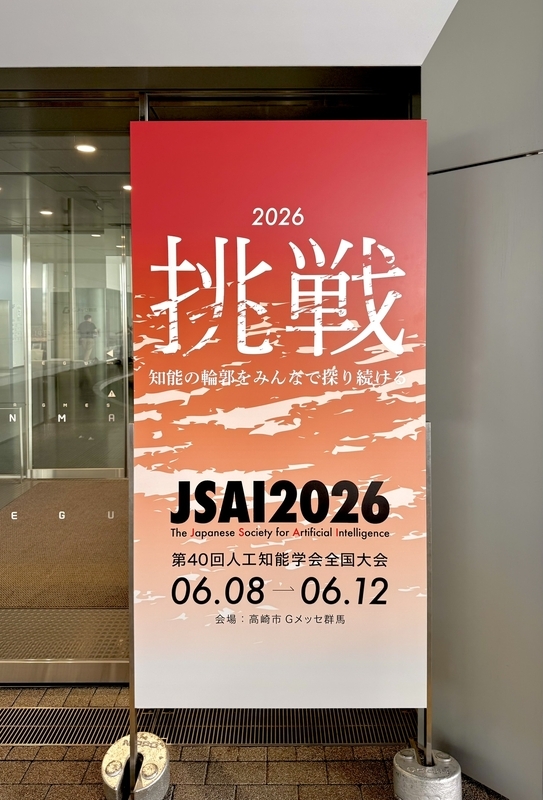
JSAI2026の会場に掲げられた学会の看板

*1:Earth Mover’s Distance (EMD) と同じ

GitHub Organization のリポジトリやアクセス権の管理に Terraform を導入しました

こんにちは。技術戦略チームの菅原です。

Faber Company 開発チームでは、GitHub Organization のリポジトリやアクセス権の管理に Terraform を導入しました。これにより、コードとして GitHub の設定を管理できるようになり、変更の追跡や再現性の向上が期待できます。

この記事では、導入に至るまでの背景や、実際の設定例、運用上のポイントなどを共有します。

背景

Faber Company では、ほぼすべてのプロジェクトが GitHub Organization 上で管理されています。 以前まではリポジトリの作成やアクセス権の設定などはすべて手動で行っていました。

リポジトリ数は130超におよび、管理が煩雑になっていたほか、同じ設定を複数のリポジトリに適用する際の手間が課題となっていました。

アクセス権の変更などの重要な設定の場合、ISMS 対応のために変更者が Notion に履歴を記録する運用が行われており、これも手間がかかる上に、記録漏れのリスクもありました。

  • 管理の手間を減らすこと
  • 同じ変更を機械的に適用できるようにすること
  • 変更履歴を自動的に記録できるようにすること

の3点を目的として、GitHub Organization の管理に Terraform を導入することにしました。

構成

Terraform の GitHub Provider を使用して、GitHub Organization のリポジトリやアクセス権の設定をコード化しています。

GitHub API を都度呼び出す都合、Plan/Apply にかなり時間がかかるため、時間の短縮を狙って責任ごとに別モジュールとし、並列して Plan を実行できるようにしました。

既存リソースのインポートは、Claude Code に gh CLI を使わせて各モジュール内のコードと terraform import 用のシェルスクリプトを生成し、それを人間が確認した後実行することで行いました。

github/
├── backend.hcl     # 共通のバックエンド定義(AWS S3)が入っています
├── FaberTechnology
│   ├── people
│   ├── permissions
│   ├── repos
│   └── teams
└── README.md

People モジュール

Organization のメンバーを管理するモジュールです。github_membership リソースを使用しています。

# people.tf
locals {
  people = {
    AdminUserId                = "admin",
    MemberUserId               = "member",
    AnotherMemberUserId        = "member",

    # その他メンバーの情報
  }
}

resource "github_membership" "member" {
  for_each = local.people

  username = each.key
  role     = each.value
}

Teams モジュール

Organization のチームを管理するモジュールです。github_team リソースを使用しています。

既存のチームに親子構造があったため、親チームと子チームを分けて管理するようにしています。また、チームのメンバーも同じ YAML ファイルから管理するようにしています。さらにネストがある場合は、最も深い構造に合わせて teams.tf を書き換える必要があります。

実動コードでは親・子・孫の3階層の構造になっていますが、ここでは簡略化して親・子の2階層の構造で例を示します。

teams/
├── main.tf
├── teams.tf
└── teams.yaml
# teams.tf

locals {
  teams_yaml = yamldecode(file("${path.module}/teams.yaml"))

  # 親チーム
  root_teams = {
    for key, data in local.teams_yaml :
    key => data if data.parent_team == null
  }

  # 子チーム
  children = {
    for key, data in local.teams_yaml :
    key => data if data.parent_team != null && lookup(local.root_teams, data.parent_team, null) != null
  }

  team_members = merge([
    for team_key, team_data in local.teams_yaml :
    merge([
      for member_item in team_data.members : {
        for username, role in member_item :
        "${team_key}_${username}" => {
          team     = team_key
          username = username
          role     = role
        }
      }
    ]...)
    if can(team_data.members) && length(team_data.members) > 0
  ]...)
}

resource "github_team" "root_teams" {
  for_each = local.root_teams

  name        = each.key
  description = each.value.description
  privacy     = each.value.privacy
}

resource "github_team" "children" {
  for_each = local.children

  name           = each.key
  description    = each.value.description
  privacy        = each.value.privacy
  parent_team_id = github_team.root_teams[each.value.parent_team].id

  depends_on = [github_team.root_teams]
}

resource "github_team_membership" "members" {
  for_each = local.team_members

  team_id = (
    contains(keys(local.root_teams), each.value.team) ? github_team.root_teams[each.value.team].id :
    github_team.children[each.value.team].id
  )
  username = each.value.username
  role     = each.value.role

  depends_on = [github_team.root_teams, github_team.children]
}
# teams.yaml
team1:
    description: "チーム1の説明"
    privacy: "closed"
    parent_team: null # 親チームの場合は null を指定
    members:
        - AdminUserId: "maintainer"
        - MemberUserId: "member"

team2:
    description: "チーム2の説明"
    privacy: "closed"
    parent_team: "team1"
    members:
        - AnotherMemberUserId: "maintainer"

Repos モジュール

リポジトリを管理するモジュールです。github_repository リソースを使用しています。

repos
├── main.tf
├── moved.tf    # リポジトリ名を変更するときに使う `moved` ブロックが入っています
├── repos.tf
└── repos.yaml
# repos.tf
locals {
  repos_yaml = yamldecode(file("${path.module}/repos.yaml"))
}

resource "github_repository" "repos" {
  for_each = local.repos_yaml

  name        = each.key
  description = lookup(each.value, "description", "")
  visibility  = lookup(each.value, "visibility", "private")
  homepage_url = lookup(each.value, "homepage_url", null)

  has_issues      = lookup(each.value, "has_issues", true)
  has_wiki        = lookup(each.value, "has_wiki", false)
  has_projects    = lookup(each.value, "has_projects", false)
  has_downloads   = lookup(each.value, "has_downloads", true)
  has_discussions = lookup(each.value, "has_discussions", false)

  archived               = lookup(each.value, "archived", false)
  archive_on_destroy     = lookup(each.value, "archive_on_destroy", true)
  vulnerability_alerts   = lookup(each.value, "vulnerability_alerts", true)
  delete_branch_on_merge = lookup(each.value, "delete_branch_on_merge", true)

  # その他のリポジトリ設定(略)
}
# repos.yaml
repo1:
    description: "リポジトリ1の説明"
    visibility: "private"
    homepage_url: "https://example.com/repo1"
    # 特に設定を書かなければ repos.tf のデフォルト値が適用されます

Permissions モジュール

ユーザーやチームがリポジトリに対して持つアクセス権を管理するモジュールです。github_repository_collaborators リソースを使用しています。

permissions/
├── main.tf
├── permissions.tf
└── permissions.yaml
# permissions.tf
locals {
  permissions = yamldecode(file("${path.module}/permissions.yaml"))
}

resource "github_repository_collaborators" "collaborators" {
  for_each   = local.permissions
  repository = each.key

  dynamic "user" {
    for_each = lookup(each.value, "users", {})
    content {
      username   = user.key
      permission = user.value
    }
  }

  dynamic "team" {
    for_each = lookup(each.value, "teams", {})
    content {
      team_id    = team.key
      permission = team.value
    }
  }

  # Organization の管理者を入れた Owners チームを別途管理しています。
  # このチームは全リポジトリにアクセス権を持っているため、 Terraform の
  # 管理からは一括して外します。
  ignore_team {
    team_id = "owners"
  }
}
# permissions.yaml
repo1:
    users:
        MemberUserId: "push"
    teams:
        team1: "maintain"

CI

GitHub Actions を使用して、Plan/Apply を実行しています。実際の運用は次のようなフローです。

  1. 変更内容を *.tf や *.yaml に記述して Pull Request を作成
  2. CI が Plan を実行して、変更内容を確認、PR にコメント
  3. 問題なければ PR をマージして、CI が Apply を実行

また、毎日定期的に Plan を実行して、GitHub 上の設定とコードの状態に乖離(ドリフト)がないかを確認する運用も行っています。ドリフトが検出された場合は、その内容を含む Issue が自動的に作成され、修正を促します。

これによって、Terraform の知識がない人でも yaml を編集するだけで GitHub の設定変更をリクエストできるようになり、変更内容も自動的に記録されるようになりました。

実際のユースケース

新しいユーザーを Organization に招待する

新しいユーザーを Organization に招待する場合は、people/people.tf の locals.people にユーザー名とロールを追加して Pull Request を作成します。

locals {
    people = {
        AdminUserId                = "admin",
        MemberUserId               = "member",
        AnotherMemberUserId        = "member",
+       NewMemberUserId            = "member",
    }
}

Organization のシート数が足りているか確認した後、問題なければマージして Apply を実行します。これで新しいユーザーが Organization に招待されます。

既存のリポジトリに新しいチームを追加する

既存のリポジトリに新しいチームを追加する場合は、まず teams/teams.yaml に新しいチームとそのメンバーを追加します。

new_team:
    description: "新しいチームの説明"
    privacy: "closed"
    members:
        - NewMemberUserId: "maintainer"

次に、permissions/permissions.yaml に新しいチームのアクセス権を追加します。

repo1:
    users:
        MemberUserId: "push"
    teams:
        team1: "maintain"
+       new_team: "push"

これで新しいチームが作成され、既存のリポジトリに対してアクセス権が付与されます。

リポジトリをアーカイブする

リポジトリをアーカイブする場合は、repos/repos.yaml の該当リポジトリの設定に archived: true を追加します。

repo1:
    description: "リポジトリ1の説明"
+   archived: true

その他の方法として、リポジトリ設定のデフォルトは archive_on_destroy: true となっているため、リポジトリのエントリごと削除された場合も自動的にアーカイブされるようになっています。

-repo1:
-   description: "リポジトリ1の説明"

運用してみて良かった点

GitHub Organization の管理に Terraform を導入してみて、以下のような良かった点がありました。

変更内容をコミット履歴として追跡できるようになった

PR のテンプレートにその変更が必要になった Slack スレッドなどを残すように運用しているため、誰がどんな理由で設定変更を必要としていたのか追跡できるようになりました。

不要なリポジトリやチームの棚卸しができるようになった

アーカイブしたリポジトリに残っている権限や、参照されていないチームなどを、Claude Code や GitHub Copilot が確認できるようになりました。人力でアクセス権を洗い出すことなく不要なリソースを削除する PR が自動生成できるようになったので、棚卸しがかなり楽になりました。

設定変更によって起こることをエージェントが予測できるようになった

「このチームからAさんを削除するとどのリポジトリにアクセスできなくなる?」などの質問に対して、Claude Code や GitHub Copilot がコードを読んで回答できるようになりました。これによって、設定変更の影響範囲を事前に把握しやすくなりました。

今後の課題

Apply の順序依存問題

リポジトリのアクセス権を管理する Permissions モジュールは、People モジュールや Teams モジュールで管理しているユーザーやチームに依存しています。そのため、これらのモジュールの変更内容によっては、Apply の順序によってエラーが発生する可能性があります。

現在は Apply を並列に実行しており、エラーが出たら失敗したモジュールを手動で再実行する運用ですが、今後はモジュール間の依存関係を明示的に管理して、Apply の順序を自動的に制御できるようにすることを検討しています。

オンボーディング・オフボーディング用ワークフローの整備

現在は、オンボーディングやオフボーディングの際に必要な変更を手動でコードに反映させる運用ですが、今後はこれらのワークフローを自動化することも検討しています。

例えば、オンボーディングの際には新しいユーザーを People モジュールに追加し、必要なチームやリポジトリへのアクセス権を自動的に付与するようなワークフローを構築することが考えられます。

オフボーディングの際には、ユーザーを People モジュールから削除し、関連するチームやリポジトリへのアクセス権を自動的に削除するようなワークフローも同様に検討しています。

その他のリソースの取り込み

アカウント管理が必要なのは GitHub だけではありません。今後は、AWS IAM や Google Cloud の IAM などのクラウドプロバイダのリソースも同様に Terraform で管理することを検討しています。

複数のサービスにまたがるアクセス権の管理を一元化し、より効率的な運用が可能になると考えています。
Cloudflare の新 CMS「EmDash」をローカルで動かしてみた

こんばんは,技術戦略チームの小林です.

本日 2026 年 4 月 2 日未明 (日本時間),Cloudflare が新しい CMS 「EmDash」 のベータ版をリリースしました.WordPress の "Spiritual Successor" (後継) を謳っていて,プラグインの脆弱性をアーキテクチャレベルで根絶するというアプローチが気になったので,早速調べてローカルで動かしてみました.

この記事では,EmDash のアーキテクチャ上の特徴と課題,実際に触ってみた所感をまとめています.

blog.cloudflare.com

WordPress のプラグインセキュリティは構造的に破綻している

WordPress は全 Web サイトの約 43% で使われている巨大プラットフォームです (W3Techs, 2026 年 4 月 2 日時点).

WordPress の強みはプラグインによる拡張性ですが,そのアーキテクチャには根本的な問題があります.

  • すべてのプラグインがコアと同一メモリ空間を共有している
  • DB・ファイルシステム・外部通信への全権限アクセスが暗黙的に許可されている
  • つまり,1 つのプラグインに脆弱性があればサイト全体が陥落しうる

WAF やマーケットプレイスの審査で表面的にガードしても,プラグインが全権限を持つ構造自体は変わりません.EmDash はここにアーキテクチャレベルで切り込もうとしています.

EmDash とは

EmDash は,Astro 6.0 と TypeScript で構築されたサーバーレス CMS です.

  • MIT ライセンスのオープンソース
  • PHP のコードは一切不使用.完全な新規構築
  • Cloudflare Workers 上でのサーバーレス実行
  • ローカル開発では SQLite,本番では Cloudflare D1 (分散 SQL)

鍵となるのは V8 Isolates.Chrome ブラウザで JavaScript を実行するのと同じ JS エンジンによる隔離実行環境で,これがプラグインのサンドボックス分離の基盤になっています.

Dynamic Workers によるゼロトラスト実行モデル

EmDash のアーキテクチャ上最も重要なのが,Dynamic Workers を活用したプラグインのサンドボックスです.

WordPress との比較

WordPress EmDash (on Cloudflare)
実行環境 コアと同一メモリ空間を共有 各プラグインが独立した V8 Isolate で実行
リソースアクセス DB・FS に無制限アクセス fs モジュールなし,直接の DB アクセス不可
権限モデル 全権限を暗黙的に付与 マニフェストで明示的に宣言 (Capability-based)
外部通信 任意の外部サーバーへ自由にリクエスト可能 宣言されたホスト名のみ許可

権限は read:content や email:send のように,必要な権限だけをマニフェストで明示的に要求し,管理者が許可する方式です.万が一プラグインが乗っ取られても,被害はそのサンドボックス内に封じ込められます.

各 Isolate には CPU 時間とメモリの上限も設定されており,単一のプラグインによるリソース枯渇 (DoS) も防止されます.

AI エージェントによる管理を前提とした設計

EmDash のもうひとつの特徴が,公式ブログで "AI Native CMS" と表現されている設計思想です.従来の CMS が人間による GUI 操作を前提としていたのに対し,EmDash は AI エージェントがプログラム経由で管理することを前提に設計されています.

  • MCP (Model Context Protocol) サーバーを標準搭載.Claude Code や Cursor などの AI エージェントが,EmDash のコンテンツやプラグインを直接操作できる
  • コンテンツは HTML ではなく構造化 JSON (Portable Text) で保存.AI が意味を直接理解しやすい
  • WordPress との互換性は Agent Skills で実現.PHP コードを実行する互換レイヤーは持たず,AI エージェントが WordPress のレガシーコードを読み取り,EmDash の TypeScript API へ移植 (port) するアプローチを採っている

ローカルで EmDash を動かしてみる

前提条件

  • Node.js (LTS 推奨)
  • pnpm

セットアップ手順

以下のコマンドで新規プロジェクトを scaffold できます.

pnpm create emdash@latest

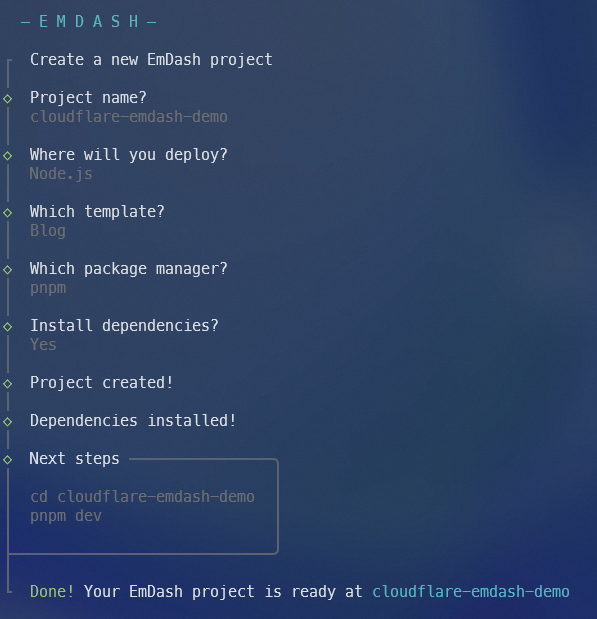
プロジェクト名,デプロイ先,テンプレート,パッケージマネージャー等を対話的に選択すると,依存パッケージのインストールまで完了した状態でプロジェクトが生成されます.

pnpm create emdash@latest の完了画面

cd cloudflare-emdash-demo
pnpm run dev

管理画面にアクセス

ローカルサーバーが起動したら,http://localhost:4321/_emdash/admin にアクセスすると管理画面が表示されます.ローカル環境では SQLite がデータベースとして使われるため,Cloudflare アカウントがなくても動作確認できます.

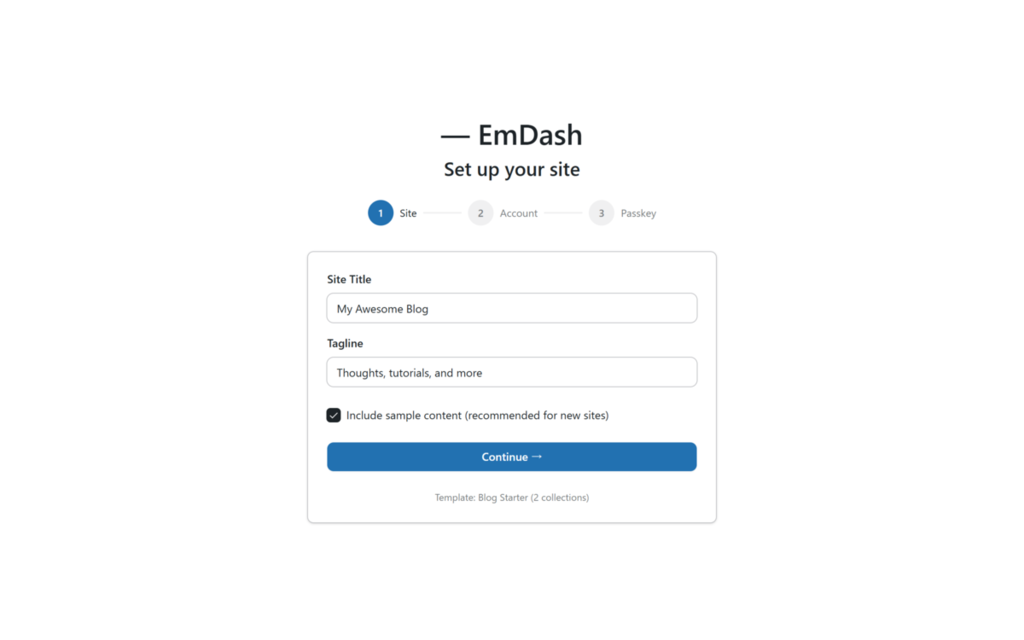
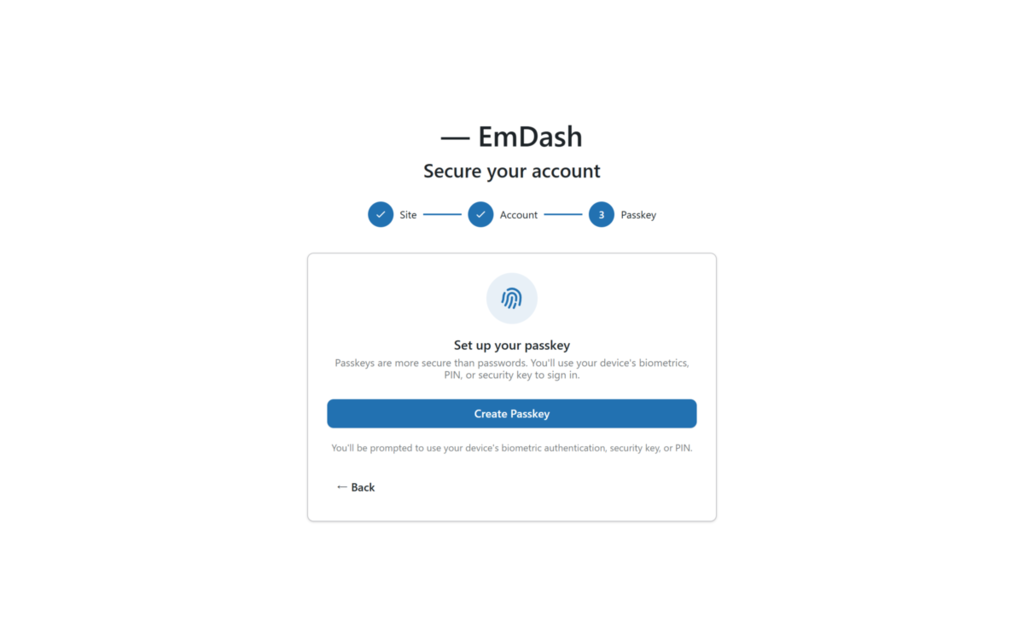
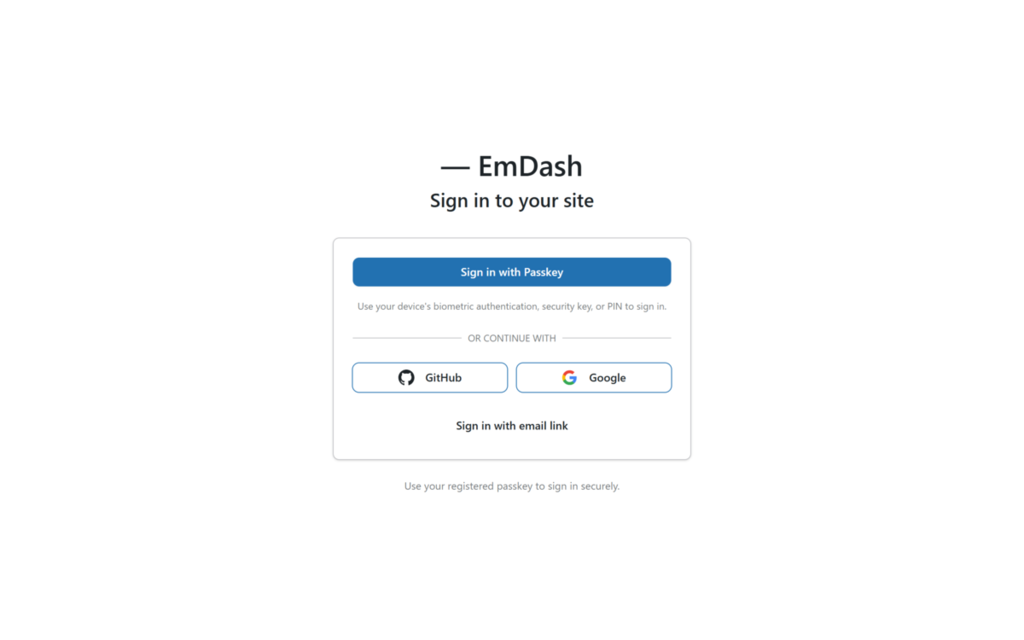
初回アクセス時はサイトのセットアップが始まります.EmDash はパスワード認証を廃止しており,パスキーの作成を求められます.

EmDash サイトのセットアップ画面
EmDash サイトのセットアップ画面

EmDash でパスキーの作成を求められた画面
パスキーの作成を求められた

パスキーを作成してサインインすると,管理画面にアクセスできます.

パスキーを使って EmDash にサインイン
作成したパスキーを使ってサインイン

EmDash の Welcome 画面
Welcome to EmDash!

プロジェクト構成

生成されるプロジェクトの構成は以下の通りです.

my-emdash-site/
├── src/
│   ├── components/     # Astro コンポーネント
│   ├── layouts/        # 共通レイアウト
│   ├── pages/          # Astro ルート
│   ├── styles/         # CSS
│   ├── utils/          # ユーティリティ
│   └── live.config.ts  # ライブプレビュー設定
├── seed/
│   └── seed.json       # コンテンツタイプとフィールドの定義
├── astro.config.mjs    # Astro + EmDash の設定
├── AGENTS.md           # AI エージェント向けのドキュメント
└── package.json

seed/seed.json でコンテンツタイプやフィールドを定義し,astro.config.mjs 内の emdash() で全体の設定を行う構成です.AGENTS.md が同梱されているのも AI Native CMS らしいところです.Astro に馴染みがあれば,直感的に理解できる構造だと思います.

Claude Code から MCP で接続する

EmDash は MCP サーバーを内蔵しており,AI エージェントから直接コンテンツやプラグインを操作できます.ただし,デフォルトでは無効になっているため,astro.config.mjs の emdash() に mcp: true を追加する必要があります.

emdash({
    mcp: true,
    database: sqlite({ url: "file:./data.db" }),
    // ...
})

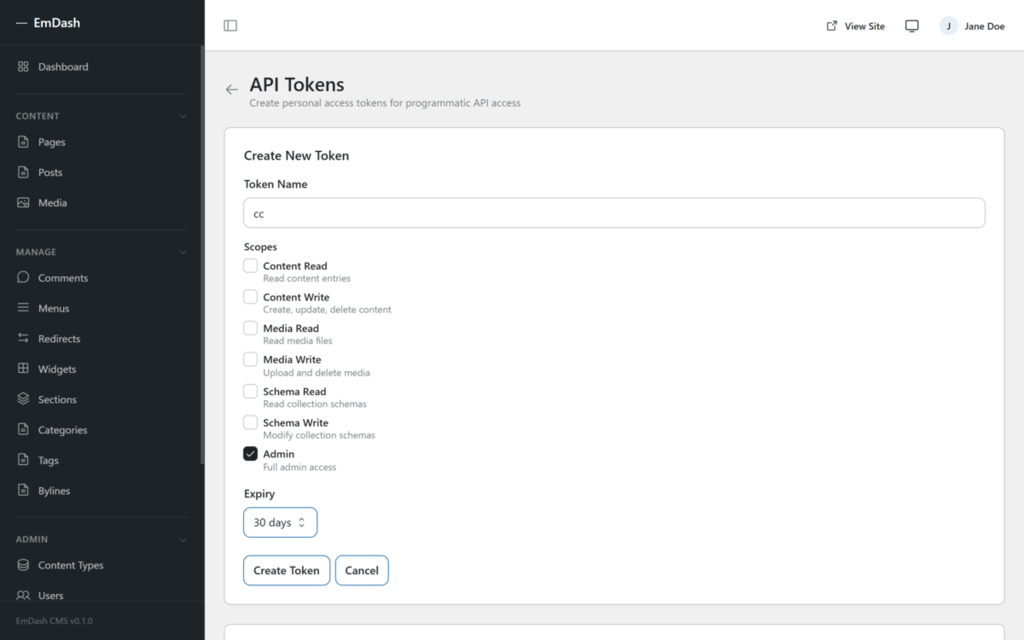
また,EmDash の管理画面 (/_emdash/admin) から API トークンを発行しておきます.

EmDash 管理画面での API トークン作成
API トークンの作成

その上で,Claude Code から以下のコマンドで MCP サーバーを追加できます.

claude mcp add --transport http emdash http://localhost:4321/_emdash/api/mcp --header "Authorization: Bearer <your-token>"

Claude Code を再起動すると,EmDash の MCP サーバーに接続され,コンテンツの操作などが可能になります.

WordPress からのインポートを試す

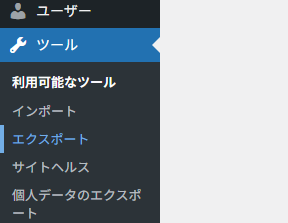
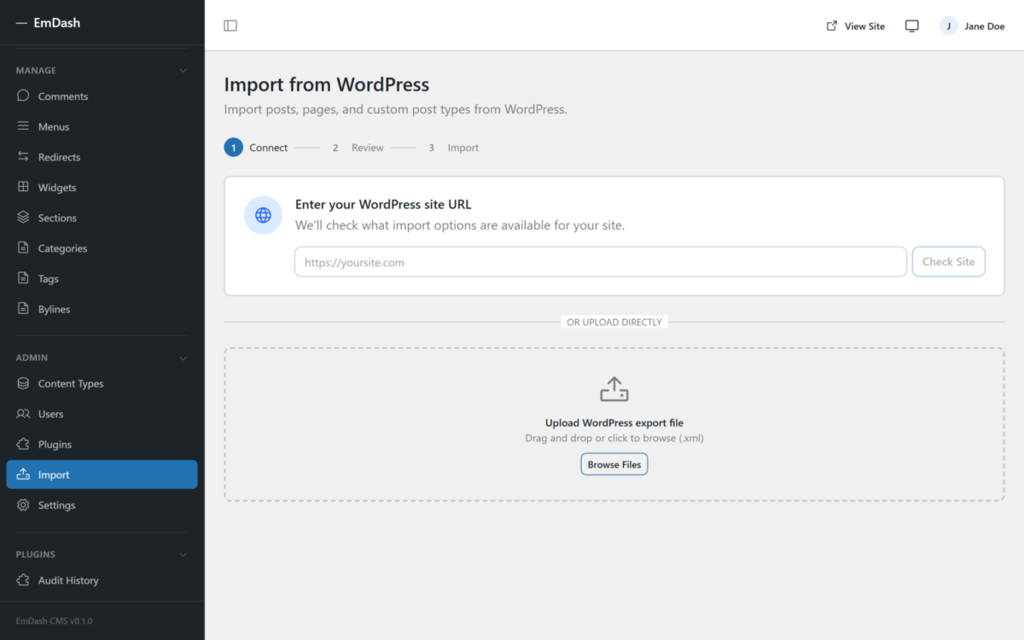
EmDash の管理画面には WordPress からのインポート機能があります.WordPress の管理画面からエクスポートした XML をアップロードしてみました.

WordPress の管理画面からエクスポート
WordPress の管理画面 → ツール → エクスポートから XML をエクスポートできる

EmDash の WordPress インポート画面
WordPress でエクスポートした XML をこの画面でアップロードする

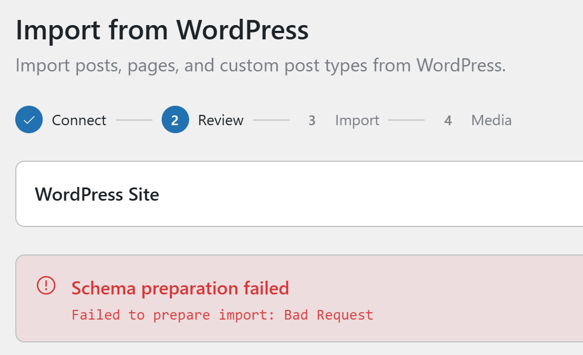
結果は Schema preparation failed でインポートに失敗しました.やはり一筋縄ではいかないようです.

Schema preparation failed でインポートに失敗
Schema preparation failed が出てインポートに失敗…

触ってみた所感

  • 管理画面の UI は WordPress を意識しつつもモダンな印象.Astro ベースなのでフロントエンドのカスタマイズ性も高そうです
  • ローカルでは SQLite で動くため,Cloudflare アカウント不要で試せるのは嬉しいポイント
  • ただし,プラグインのサンドボックス分離 (Dynamic Workers) はローカルでは機能しません.EmDash の最大の価値であるゼロトラスト実行モデルは Cloudflare 環境でのみ有効です
  • Dynamic Workers は現在 Cloudflare の有料プラン ($5/月〜) でのみ利用可能です.ローカルやその他の環境では,プラグインはインプロセスで実行され,分離は行われません
  • MCP 経由での AI エージェント連携や WordPress からの移行については,機会があれば別の記事で掘り下げてみたいと思います

現時点の課題と制約

革新的なアーキテクチャだと感じましたが,現時点では大きな制約もあります.

エコシステムの不在

WordPress.org 公式リポジトリには 62,000 以上の無料プラグインと 14,000 以上の無料テーマが登録されています (2026 年 4 月 2 日時点).EmDash はサンドボックスによるプラグイン分離があるため,公式ブログでも "breaks free of the centralized marketplace" と述べられており,マーケットプレイスの審査に頼らずともプラグインの安全性を担保できるとしています.しかし裏を返せば,現状ではプラグインのエコシステム自体がほぼ存在しません.

テーマの移行

WordPress のテーマもプラグインと同様に PHP で書かれており,コアと同じ権限で動作します.公式ブログでも以下のように指摘されています.

WordPress themes, though incredibly flexible, operate with a lot of the same security risks as plugins

— Introducing EmDash (Cloudflare Blog)

EmDash のテーマは Astro プロジェクトとして構成され,DB 操作が不可能な設計ですが,既存の WordPress テーマ資産を EmDash に移行するには Astro での再構築が必要になり,プラグインと並んで移行の大きな障壁となります.

ベンダーロックイン

公式リポジトリによると,EmDash は各レイヤーにポータブルな抽象化 (Kysely for SQL 等) を採用しており,任意の Node.js サーバーで動作します.ただし,プラグインのサンドボックス分離 (Dynamic Workers) は Cloudflare 環境でのみ機能するため,他環境ではこのセキュリティ上の優位性が失われます.

レイヤー Cloudflare 代替環境
DB D1 (分散 SQL) SQLite / PostgreSQL / Turso
ストレージ R2 S3 互換 / ローカルファイル
セッション KV Redis / ファイルベース
プラグイン実行 Worker Isolates
(サンドボックス)
インプロセス
(分離なし)

保守性についてのコミュニティの議論

EmDash は熟練の開発者が AI エージェントを活用し,わずか 2 ヶ月で構築したとされています.この開発速度自体が Cloudflare のエンジニアリング力の証明ですが,Hacker News や Reddit では,AI が生成したコードの長期的な保守性について議論が交わされています.

まとめ

EmDash が目指しているのは,プラグインが全権限を持つという構造的な欠陥をアーキテクチャで解消することです.

  • V8 Isolates とマニフェスト権限によるゼロトラスト実行モデル
  • AI エージェントによる管理を前提とした "AI Native" な設計が示す CMS の新しい方向性
  • ただし,エコシステム不在やベンダーロックインなど現時点の制約は大きい

セキュリティは「外から守る」だけでなく,「構造で封じ込める」.CMS に限らず普遍的な設計思想だと感じました.課題は多いですが,EmDash の今後の動向は引き続き注目していきたいと思います.

参考リンク

【参加報告】第5回計算社会科学会大会(CSSJ2026)に参加しました!

AIイニシアティブチームの稲岡です。

2026年3月2日〜4日にクリエート浜松で開催された第5回計算社会科学会大会 (CSSJ2026)に、Faber Company は公式スポンサーとして協賛し、私も現地で参加してきました。

計算社会科学は、情報技術を使って人間の行動や社会現象を定量的に解明することを目指す学際的な分野です。今回の大会でも、招待講演・口頭発表・ポスター発表を通じて幅広いテーマの議論が交わされました。

css-japan.com

なぜSEOの会社が計算社会科学会に?

「SEOの会社が、なぜ社会科学の学会に?」と思われるかもしれません。

ファベルは「辺境の知から、“マーケティングゼロ”を実現する」をパーパスとして掲げています。素晴らしい商品やサービスが、それを必要としている人に届く世界をつくること。その実現のためには、個々の企業のマーケティングを支援するだけでなく、「正しい情報が人に届く仕組み」そのものについて考える必要があります。

Webを通じた情報の流通を考えるとき、「人々がWeb上でどのように情報を探し、受け取り、広めるのか」という社会的なメカニズムの理解が欠かせません。計算社会科学はまさにそのような問いに計算的手法でアプローチする分野です。情報拡散の構造、ユーザーの信頼形成、コミュニティの分極化などは、検索やコンテンツの在り方について根本から考える上で重要なテーマです。

そうした背景からファベルは計算社会科学の研究に注目しています。学会参加を通じて最新の研究動向を把握し、社内のプロダクト開発やマーケティング支援に活かしていきたいと考えています。

注目した研究

多くの発表の中から、ファベルの事業と特に関わりが深いと感じた2件を紹介します。なお、いずれの論文も現時点では一般公開されていませんが、今後公開され次第リンクを追記する予定です。

ミクロなユーザ介入がマクロな誤情報の普及に及ぼす影響の評価

著者: 古谷 諭史, 芝原 俊樹, 秋山 満昭(NTT株式会社 社会情報研究所)

ナッジ(正確性を意識させる働きかけ)、プレバンキング(誤情報への予防教育)、文脈注釈(Xのコミュニティノートのような補足情報の付与)といったユーザ介入は、個人レベルでは誤情報の共有を抑制することが実証されています。しかし、その効果が社会全体での誤情報拡散の抑制にどの程度つながるのかは十分に明らかになっていませんでした。

この研究は、X の実際のフォロワーネットワークと拡散履歴データを用いて、連続時間独立カスケード (CTIC) モデルを現実の拡散速度や規模に合わせてキャリブレーションし、ユーザ介入の効果をシミュレーションしています。 このモデルにおいて、各ユーザ介入を「情報の受け手の感受性を低減させる操作」として統一的に表現し、介入の強度・規模・タイミング・ターゲット選択を変化させて評価を行っています。 その結果、現行のユーザ介入は単独では普及を5〜10%程度しか抑制できず、すべての介入を併用しても現実的なシナリオでは最大30%程度の抑制にとどまることが示されました。

正しい情報を届けることを考える上で、個人の行動変容を促すミクロな介入には構造的な限界があり、情報の流通構造やアルゴリズムといったシステム全体へのアプローチがより重要になると改めて感じさせられる研究でした。

シリコンサンプリングは大規模社会調査と互換性を有するか? :日本における人間と LLM の回答分布比較分析

著者: 海老原 優(東洋大学大学院 / 株式会社エモスタ), 小川 修平(株式会社エモスタ)

「シリコンサンプリング」とは、LLM に人口統計学的情報(居住地域・性別・年齢・職業・学歴など)を与えて仮想人格を設定し、アンケートに回答させることで調査データを生成する手法です。コストや時間の削減、仮説生成の効率化などが期待される一方、LLMの回答が人間の回答とどの程度一致するのかについては、特に日本のような非WEIRD圏*1では十分に検証されていませんでした。

この研究では、消費者庁の「消費者意識基本調査」から選んだ40問に対し、実際の調査回答者と同数の5,046人分のシリコンサンプルを作成して、人間とLLMの回答分布を比較しています。全体の分布差は中程度で、多肢選択形式の質問では差が小さい一方、順序尺度形式(「満足している〜不満である」のような段階評価)では差が大きいことがわかりました。LLMの回答は社会的に望ましい選択肢への偏りや、順序尺度での中心化傾向が観察されています。

LLMに人間のふるまいを模倣させるアプローチは、アンケート調査に限らず広がりを見せています。たとえば、LLMエージェントにWebサイトを操作させてA/Bテストやユーザビリティテストを行う研究も登場しています。こうした手法でもLLMエージェントは目的志向的・効率的に振る舞いがちで、人間のような探索的・非線形的な行動の再現が課題とされています。今回の研究で観察された「特定の回答への偏り」は、アンケートに限らずLLMによる人間シミュレーション全般に通じる課題だと感じました。

まとめ

「情報と人との関わり」を計算的に捉える研究は、ファベルが向き合う課題と地続きです。今回得た知見を社内に持ち帰り、プロダクト開発やマーケティング支援に反映していきたいと考えています。

浜松駅のホームにある駅名標の写真

*1:WEIRD: Western, Educated, Industrialized, Rich, Democratic の頭文字。心理学・社会科学の研究が欧米先進国の被験者に偏っていることへの批判的概念

文系卒・新卒2年目の女子が基本情報技術者試験に一発合格した話

皆様お久しぶりです。気づいたら前回の記事公開からかなり時間が経っていて、内心結構焦っている高田です。

今回は、私が基本情報技術者試験(以下「基情」)に無事一発合格するまでの、思い出すだけで苦しい紆余曲折について書いてみたいと思います。

今まさに合格を目指して頑張っている方、あるいはかつて挫折したけど再度チャレンジしようか迷っている方の一助になれば幸いです。

時間を制するものは基情を制する

基情に限らない話ですが、社会人が働きながら勉強時間を捻出することは、思っている以上に難しいです。

その上、基情はとにかく範囲が広い。エンジニアの方や、高校あるいは大学で情報科学系の勉強をされていた方ならまだ何とかなるかもしれませんが、高田はなんと文系女子。事前知識がゼロの状態から挑むには、相当な量の勉強が必要でした。

「でもFaber Companyって週休完全2日制でしょ??土日に勉強すればいいじゃん」と思う方もいらっしゃるでしょう。しかしここが盲点。

1週間ガッツリ仕事をしてしまうと、先週末に勉強したことなんてとっくに忘れてしまうのです。

とりあえず、なんとか毎日、少しでもいいから勉強して、「基情に触れていない時間」をなるべく短くしなければならない。

ということで私は、すーさんのチャンネルを"ながら見"する生活を始めました。

www.youtube.com

YouTubeのいいところは、何度でも見返せるところ。1回で全てを覚える必要はないので、「なんかそんなワード出てきたなー」という感覚を掴むことを目標にしながら、繰り返し見続けました。

過去問演習でぶつかったハードル① OSI参照モデル

そんなこんなで"ながら見"を続け、内容の6割くらいが入ってきたかな〜〜と感じられるようになったら、次は過去問です。

そしてこの過去問が、まーーーーーーーあ難しい。

「動画で見た覚えはあるけど、そんなことまで覚えてない!!」というものが多々ありました。

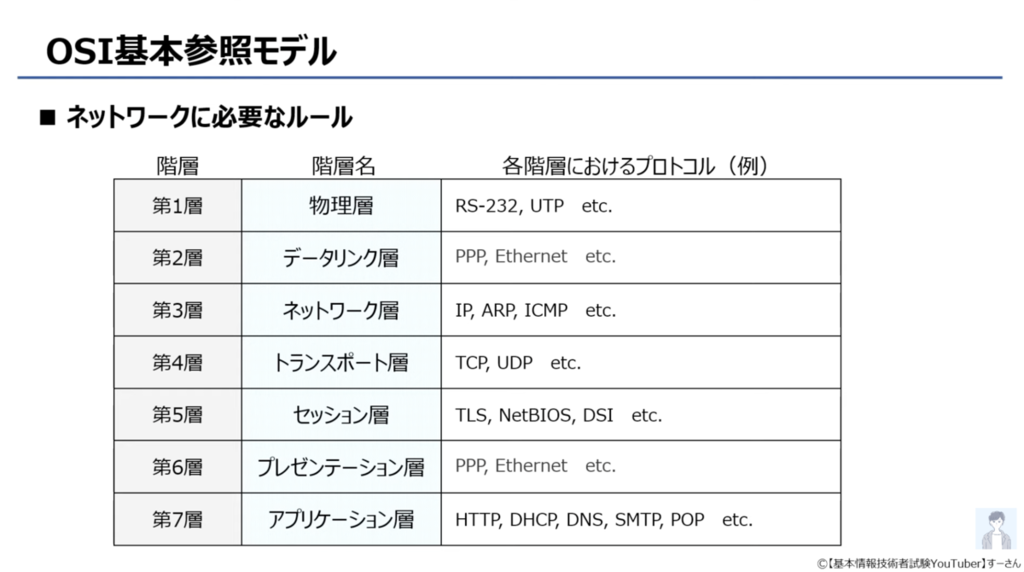
まず最初にぶつかった壁が、OSI参照モデルです。

すーさんの動画(https://youtu.be/o2TqCYxj-YA?si=cLepC1ESaJGo5keM)より

そもそも、順番が覚えられない。そして、関連するプロトコルも覚えられない。

表ごと覚えてしまった方が早いと思い、何度も紙に書いて覚えました。

※試験が終わってから、「アプセトネデブ」という覚え方があることを知りました。「OSI参照モデル 覚え方」となぜ検索しなかったのか、、、、SEOの会社なのに、、、。

過去問演習でぶつかったハードル② IPアドレス

次にぶつかった壁が、IPアドレスです。

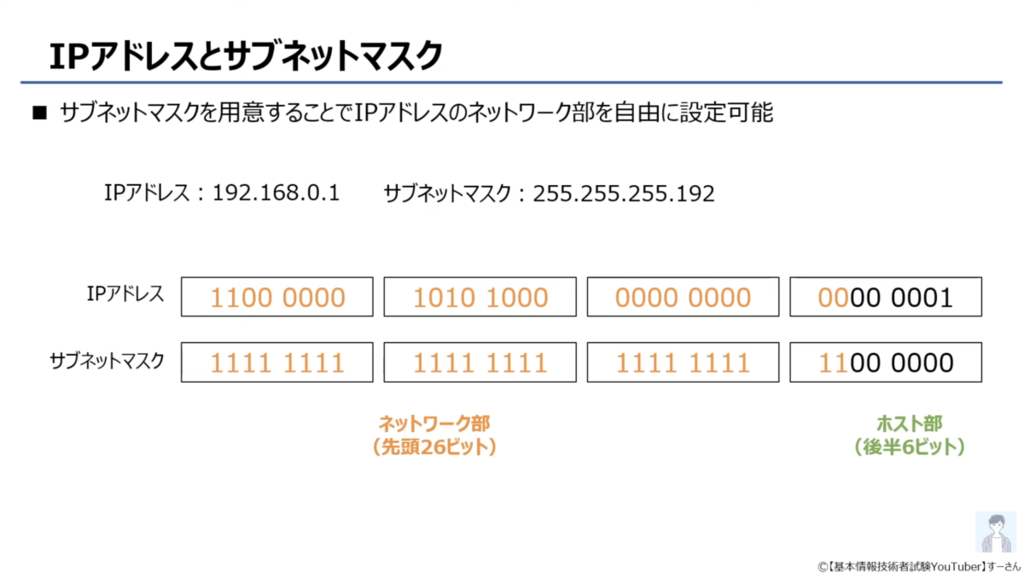
文系とはいえ数学は得意だったので、2進数は問題なかったのですが、、、、ホスト部とかサブネットマスクとかね。意味わかんないよね。

すーさんの動画(https://youtu.be/xB8g3V_P9Lo?si=Jbd_wdO685aa155g)より

ということで、最後の最後まで、IPアドレスは苦手なままでした。根性でできるようにはしたけど。今も結構自信ないです。

擬似言語のアルゴリズムはPythonをやっておくと結構楽になる

苦戦した範囲も多かった基本情報技術者試験ですが、意外とすんなり行ったものもありました。

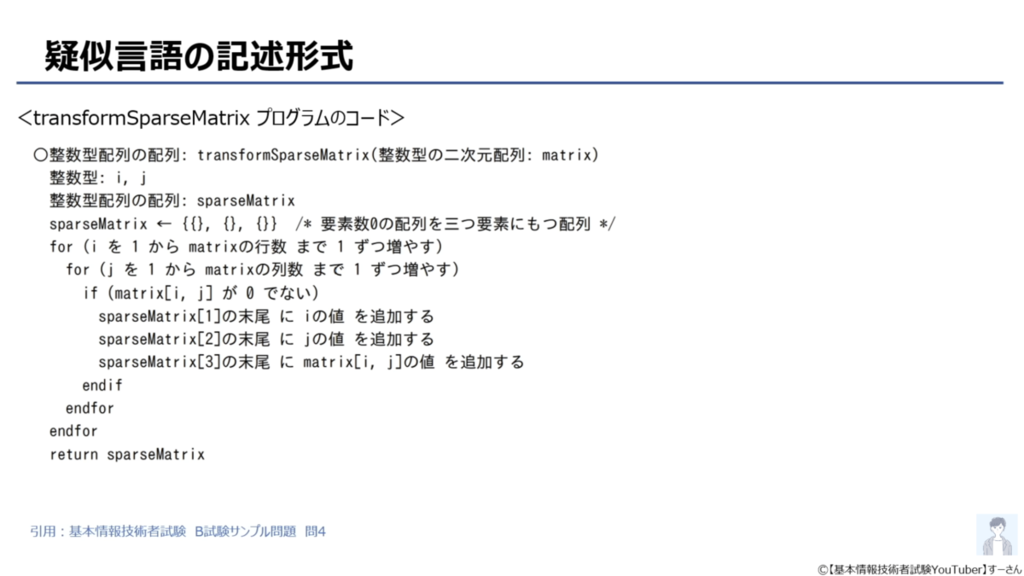
その一つが、擬似言語で出題されるアルゴリズム問題です。

すーさんの動画(https://youtu.be/wFpyeWto8Og?si=t9uOw0jEWdN9BgCl)より

ノンエンジニアにとって、アルゴリズム問題は、特に得点が難しい範囲です。

「アルゴリズム問題 攻略法」と調べると、ほとんどの記事や動画で、「選択肢を全部試せばいい」とか、「実際に値を代入して処理を最初から順番にやればいい」と書いてあります。

それは全くその通りなのですが、それ以上に、「この行までわかるのに、次の行から急にわからなくなる」というパターンが非常に多いように思います。

そこでおすすめなのが、プログラミング言語を実際に触っておくこと。特にPythonがおすすめです。

そう、アルゴリズム問題では、繰り返しや呼び出しの処理を含むものが多く出題されます。そこで、同じように繰り返しや呼び出しが多いPythonを、ある程度読めるところまで学習したことで、このつまづきがかなり軽減されるのです。

私はPythonではありませんが、以前Javaを少々かじっていたので、繰り返しや呼び出しの処理もすんなり受け入れることができました。 (ちなみに私は同時期にSQLもやっていたので、データ系の問題も結構すんなり行きました)

fabercompany-dev.hatenablog.com

もしアルゴリズム問題が苦手な方や、「なかなか手を付けられない」という方がいらっしゃったら、一旦なんらかの言語を触っておくことをおすすめします。

特にPython、Java、SQLの3つは、科目Aでも出題される可能性が高いので、触っておいて損はしません。

予想以上にしんどかった本番

そうして迎えた本番。その日は、史上最強・史上最長といわれた寒波が到来する日で、会場に行くまでの時間は特に風が強かったのを覚えています。

会場に着き、注意事項を受けて、いざ試験開始。過去問は10周以上したし大丈夫、、、、、と思ったのもつかの間。

開始して10分ほどで、「あ、もうこれダメだわ、落ちたわ」と悟りました。

科目Aは「見たことも聞いたこともあるはずなのに思い出せない」問題が多発。

さらに、休憩を挟んで開始した科目Bは、「自分が出した答えが、どの選択肢にも当てはまらない」という最悪の状態にたびたび陥ります。

もっとちゃんと勉強しておけばよかった、、、、、と後悔しながら、なんとか試験を終えました。

CBT方式なので、試験が終わった直後に点数が表示されるのですが、科目A・Bともに合格ラインを超えていたのが嘘だと思いました。

しかし、人間は結局、「終わりよければ全てよし」なのかもしれません。記憶を頼りに答え合わせと復習をし、テキストを見なくなってから数日後、「ま、受かってたからいいか」という思考に落ち着きました。

そして約1か月後、IPAのマイページできちんと合格したことを確認し、あの合格報告ポストに至る、というわけです。

これから基情を受ける方へのアドバイス

これから基情を受ける方に一つアドバイスをするなら、「過去問の丸暗記は良くない」ということです。

基情の問題では、「仕組みをしっかり理解できているか」を問う問題が多いです。我々はついつい過去問を何周もして、問題のパターンを覚えて安心してしまいがちですが、これは非常に危険です。

すーさんの講義の動画を何周もして、きちんと仕組みを理解して臨んだ方が安全です。

あと、もし会社から資格取得の手当が出ないのであれば、できるだけ一発合格を目指しましょう。

受験料が7,500円もします。調べてみたら、英検3級よりも高かったです。地味にお財布に響きます。

(最後の最後にお金の話をするのはケチだとわかっているのですが、この記事を書く直前に、「受験料こんな高いの!?」と嘆いているXのポストを見かけたので、、、)

というわけで、私が基本情報技術者試験に無事一発合格するまでの、思い出すだけで苦しい紆余曲折は、これにて終了です(急)。

これから基情を受験される方、最後まで諦めずに頑張ってください!応援しています!!!

情報処理安全確保支援士「オンライン講習(2025年度)」を受講しました

Faber Company 技術戦略チームの菅原です。

2026年1月にベトナムから帰国して所属が変わりました。帰国の話はまた別の機会にするとして、今回は情報処理安全確保支援士の「オンライン講習(2025年度)」を受講したので、その内容や感想を共有します。

情報処理安全確保支援士とは

情報処理安全確保支援士(登録情報セキュリティスペシャリスト、登録セキスペ)は、独立行政法人情報処理推進機構(IPA)が管理する「サイバーセキュリティ対策を推進する人材の国家資格」1です。

サイバーセキュリティ対策を担う人材の育成・確保のために策定されており、経済産業省の「情報セキュリティサービス基準」における情報セキュリティサービスの提供や、クレジットカード業界のセキュリティ基準である「PCI DSS」の監査など、幅広い分野で専門性を示す資格として知られています。

オンライン講習とは

情報処理安全確保支援士の資格を維持するため、以下の講習を受講することが定められています。

  1. 1年に1回の「オンライン講習」
  2. 3年に1回の「実践講習」または「特定講習」

オンライン講習は、情報処理安全確保支援士の資格を維持するために毎年受講が必要な講習です。

情報処理安全確保支援士として必要な知識や心構えを扱う初年度の講習と、最新のサイバーセキュリティ動向や対策方法を扱う2年目以降の講習(各年度版)があります。私は2024年4月に資格を取得したので、今回は2025年度の講習を受講しました。

受講料は2万円(非課税)です。

オンライン講習の内容

オンライン講習はスライド形式で提供されています。内容についてはシラバスがIPAのサイトに公開されていますので、誰でも確認できます。

今回受講した2025年度の講習は、以下の6単元で構成されています。

  • 登録セキスペに期待される役割と知識
  • AI利活用とAI規制の動向
  • AI利活用に向けたセキュリティ管理の動向
  • 脅威インテリジェンスの生成と活用
  • ランサム被害への対応
  • コンプライアンスとガバナンス

特にAIに関する内容が多いのが印象的です。実務でのAI活用が進む中で、登録セキスペとしてもAIに関する知識や対策が求められていることがわかります。

単元の終わりには5問の確認テストがあり、全問正解で合格となります。すべての確認テストに合格し、最後のアンケートに回答することで、講習の修了となります。

標準学習時間は6時間ですが、私の場合は業務の隙間時間で進めたため、全体で1週間ほどかかりました。

気になった参考文献

講習内で紹介されていた参考文献の中で特に気になったものを、NotebookLMによるまとめとともにいくつか紹介します。

広島AIプロセスに関するG7首脳声明 | 外務省

2023年に日本が議長国を務めたG7広島サミットにおいて、生成AIの国際的な指針を確立するために発表された首脳声明をまとめたものです。主な内容として、最先端のAIを開発する企業や団体が遵守すべき国際的な指針と、具体的な指針となる行動規範が提示されています。急速に進化する技術に対して共通のルールを設け、安全で信頼できる活用を促進することを目的としています。

私は広島出身で、G7首脳会議が広島で開催されたこともあって、この声明が取り上げられていたことは特に印象に残りました。

AIの安全な利活用に向けた国際的な協力の重要性が強調されており、目の前のAI活用ガイドラインが国際的な取り組みの中でどのように位置づけられるかを理解するのに役立ちました。

人間中心のAI社会原則

AI技術の進展に伴い日本が目指すべき「人間中心のAI社会」の構築に向けた基本指針をまとめたものです。少子高齢化や持続可能性といった社会課題を解決するため、AIを「公共財」と捉え、人間の尊厳や多様性を尊重するSociety 5.0の実現を提唱しています。また、AIを適切に使いこなすための「AI-Readyな社会」への変革を求め、技術の恩恵をすべての人が享受できる環境整備の重要性を説いています。

AI技術が日本や世界に対してよい影響を及ぼすために、社会が整備しておくべき環境要素について触れられているのが印象的でした。技術的な側面だけでなく、人間がAIをどのように使いこなすべきかを社会システムとして実装するというアプローチは、普段のプロダクト開発には欠けていた視点だと感じました。

国境を越えたガバナンス構築の重要性にも触れられており、AIの能力を活用しつつ、その限界や問題にも真摯に向き合う体制が求められていることがわかります。AIを使いこなす組織を作るうえで参考になる資料です。

ソフトウェア管理に向けたSBOM(Software Bill of Materials)の導入に関する手引

ソフトウェアの透明性を高めるSBOMの導入と活用を支援するための実践的なガイドラインです。サイバーセキュリティの脅威が増大する中、ソフトウェアに含まれるコンポーネントの依存関係を可視化し、脆弱性管理やライセンスコンプライアンスを効率化する手法を解説しています。さらに、実証実験に基づくコスト削減効果や、導入に際して生じがちな誤解と事実についても詳述されています。

SBOMとは、ソフトウェアの部品表のようなもので、ソフトウェアに含まれるコンポーネントや依存関係をリスト化したものです。

当社では本格的なSBOMの運用には至っていませんが、上場企業として求められるセキュリティ対策の一環として検討の価値があると感じています。具体的な導入効果や、既存の構成管理ツールとの組み合わせ方など、実務に役立つ内容が多く含まれており、SBOMの導入を検討する際の参考になりそうです。

AIを用いたクラウドサービスの安心・安全・信頼性に係る情報開示指針(ASP・SaaS編)

AI機能を搭載したクラウドサービス(ASP・SaaS)の安全性や信頼性を確保するために、事業者が公開すべき情報項目をまとめた情報開示指針です。利用者が安心してサービスを選択できるよう、財務状況や組織体制といった経営基盤から、AIの精度や責任分担まで多岐にわたる項目が設定されています。特に情報セキュリティ対策や個人情報の取り扱い、障害発生時のサポート体制については詳細な開示が求められています。

当社のサービスにもAI機能が組み込まれているため、会社として公開すべき情報を整理するうえで参考にできそうです。契約時のセキュリティチェックで必要とされる内容と重なっている部分も多く、安心してサービスを選んでいただけるように情報公開の姿勢を示す必要性を感じました。

セキュリティ関連費用の可視化

IPAが提供する、サイバーセキュリティ対策の予算確保を支援するツール「NANBOK」です。企業の経営層と実務担当者の間にある認識のギャップを埋めるため、被害想定を具体的な損害額として算出できるのが特徴です。利用者は、業界や脅威シナリオを選択して自社情報を入力することで、対策によるリスク低減効果を数字で可視化できます。

登録セキスペ共通の悩み事に、セキュリティ対策のための予算や工数の確保があります。自社が抱えるリスクを具体的な数値として把握すれば、経営層への説明や予算確保が容易になります。セキュリティ戦略を根拠をもって説明するためのツールとして使えば、社内でのセキュリティ対策の理解促進や、より効果的な予算配分につながる可能性があると感じました。こうしたツールがIPAから提供されていることは、登録セキスペにとって心強い支援になると思います。

まとめ

オンライン講習は、登録セキスペとしての知識や心構えをアップデートするための重要な機会です。特にAIに関する内容が充実しており、今後のセキュリティ対策においてAIがますます重要な役割を果たすことが予想される中で、最新の動向を把握することができました。

AIを使わない組織運営はもはや考えられない状況になっています。AIを安全かつ効率的に活用するための知識や対策を身につけることは、登録セキスペとしての価値を高めるだけでなく、組織全体のセキュリティレベルを向上させることにもつながります。

プロダクト開発においても、ミエルカシリーズを安心して活用いただけるよう、今後も最新のセキュリティ動向をキャッチアップし、実務に活かしていきたいと思います。

【入社エントリ】Faber CompanyにPdMとして入社しました(大塚れいな)。

自己紹介

2025年10月、Faber CompanyにPdMとしてジョインしました大塚れいなです。 所属は、ミエルカシリーズの開発・運用を担う新規開発ラボチームです。

入社初日、オフィスのあるWeWork神谷町トラストタワーへ。

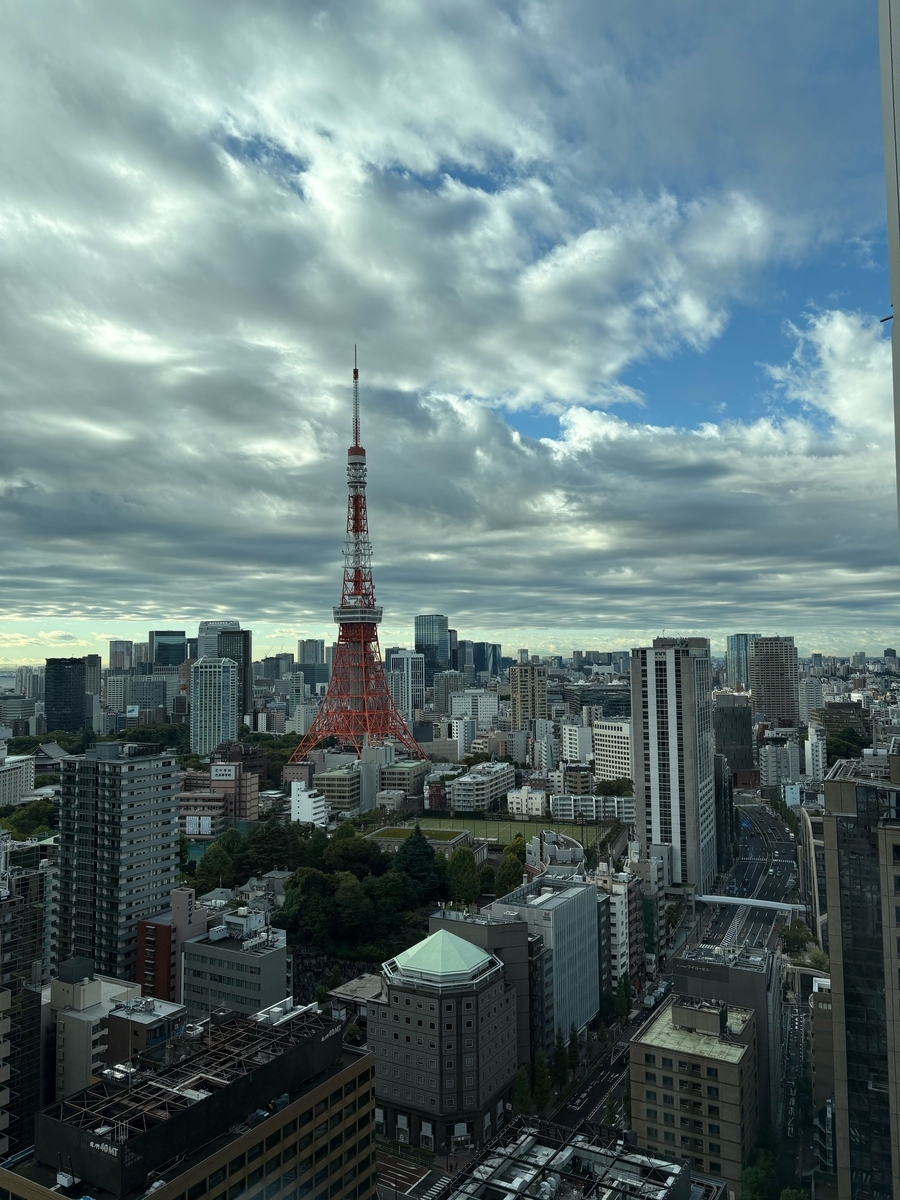
WeWork22階の一角にあるオフィスからふと外を眺めると、目の前に東京タワー。 「都心だな~」と思いつつ、洗練された設備と、チームの顔が見えるちょうどよい規模感のオフィスに、心地よいスタートを切りました。

22階のオフィスの窓から外を見た景色。東京タワーが近い。

これまで、楽天で複数の新規サービスの立ち上げに携わり、アプリケーションエンジニア、PjM、PdMとしてプロダクト開発に関わってきました。 「つくって、使ってもらって、改善して、もっと喜んでもらう」、そんなプロダクトづくりの楽しさを実感したのもこの頃です。

その後、行政機関での入国手続きアプリ開発にも携わりました。 “国のサービス”であっても、使いやすさや体験価値が欠かせないことを再認識した経験です。

さらに、コンサル企業やスタートアップにも在籍し、民間・行政、大企業・スタートアップと幅広い環境でプロダクトに携わってきました。 振り返ると、私の仕事の軸は一貫して「世の中を少しでも良くするプロですトをつくること」でした。 現場起点で課題を見つけユーザーに確かな価値を届ける、その積み重ねをこれからも続けていきたいと思っています。

Faber Companyに惹かれた理由

実は、Faber Companyを知ったのは今回が初めてでした。 マーケティング領域の経験がなかった私にとって、未知の世界。 それでも選考を進める中で感じたのは、出会うメンバー全員が前向きで真摯に仕事に向き合っていたことでした。

「より良いビジネス・プロダクトを世の中に届けたい」、そんな想いを一緒に進めていけるのでは、という想いが芽生えました。

また、成長フェーズにありながらも裁量が大きい規模感も魅力でした。 個の力がプロダクトや事業の方向性に影響を与えられる、その手触り感に惹かれました。

オフィスの入り口。ミエルカくんがお出迎え。

入社してからの1か月

入社翌日、全社合宿に参加しました。(入社のタイミングがそんな時期だったのです。) 正直、「いきなり合宿!?」と戸惑いましたが(笑)、結果的に参加して本当によかったです。

創業者・古澤さんの起業ストーリー、会社の歩み、上場までの道のり、そして今期の目標──。 会社の全体像を一気に掴むことができ、Faberが目指す未来を肌で感じる時間でした。 地方メンバーとも直接顔を合わせられたのも貴重な機会でした。

また先週は、Japan IT Weekの展示会にも参加。 営業チームに混じってリード獲得要員として初参戦しました。 整った仕組みの上に「最後は人で勝負!」というチームの熱量があり、圧倒されつつも刺激的でした。

まだまだわからないことだらけですが、質問すれば誰もが快く教えてくれる環境に助けられています。

(蛇足ですが、WeWorkでは時間限定でビールが無料らしいです。まだ飲めていませんが、密かに楽しみにしています🍺)

これからやっていきたいこと

マーケティング領域に本格的に関わるのは、私にとって初めての挑戦です。 今後は、AIの進化を活かしてミエルカシリーズをよりユーザーに価値を届けるプロダクトに育てていくことを目指しています。

ミエルカシリーズ。

同時に、チームメンバーが「仕事が楽しい」と感じられる環境づくりにも力を入れたいです。 “コト”に注力し、価値を出し、なんでも楽しむ──そんなチームを一緒につくっていけたらと思っています。

Faberという環境は、私にとって新しい挑戦の連続。 でも、それをとことん楽しみ尽くすつもりです。

最後に

まだまだ始まったばかりですが、早くキャッチアップして、 時代の先をつくるプロダクトを世の中に届けられるPdMになりたいと思っています。

きっと大変なこともあります。 それでも、新しい仲間やお客様との出会いを大切にしながら、この環境を楽しみ尽くしたいです。

これからどうぞよろしくお願いします~!